
Какая видеокарта нужна для нейросетей: расчёт видеопамяти под модель и задачу
Короткий ответ: главный параметр видеокарты для нейросетей — объём видеопамяти. Модель должна целиком поместиться в память GPU вместе с контекстом запроса. Для языковой модели на 7–8 млрд параметров достаточно карты на 16 ГБ, для 30-миллиардной — 24–48 ГБ, для 70-миллиардной — 48 ГБ и больше или несколько GPU. Обучение требует в несколько раз больше памяти, чем запуск.
Ниже — формула расчёта, таблица по размерам моделей и выбор между игровой и серверной картой.
Почему для нейросетей важна видеопамять, а не только мощность
Нейросеть — это миллиарды чисел (параметров), которые при каждом запросе нужно прочитать из памяти. Если модель не помещается в видеопамять, она либо не запустится, либо часть данных уйдёт в оперативную память компьютера, и скорость упадёт в разы.
Поэтому порядок выбора такой:
- Объём видеопамяти — поместится ли модель.
- Пропускная способность памяти — как быстро модель генерирует ответ.
- Вычислительная мощность — тензорные ядра, производительность в TOPS — важна для обучения и обработки больших пакетов данных.
Как рассчитать видеопамять под модель
Видеопамять (ГБ) ≈ число параметров (млрд) × байт на параметр × 1,2
- Байт на параметр зависит от формата весов: 2 байта в FP16/BF16, 1 байт в 8-битной квантизации, около 0,5 байта в 4-битной.
- Коэффициент 1,2 — запас на контекст (KV-кэш) и служебные данные. Для длинных документов и многих одновременных пользователей запас нужен больше.
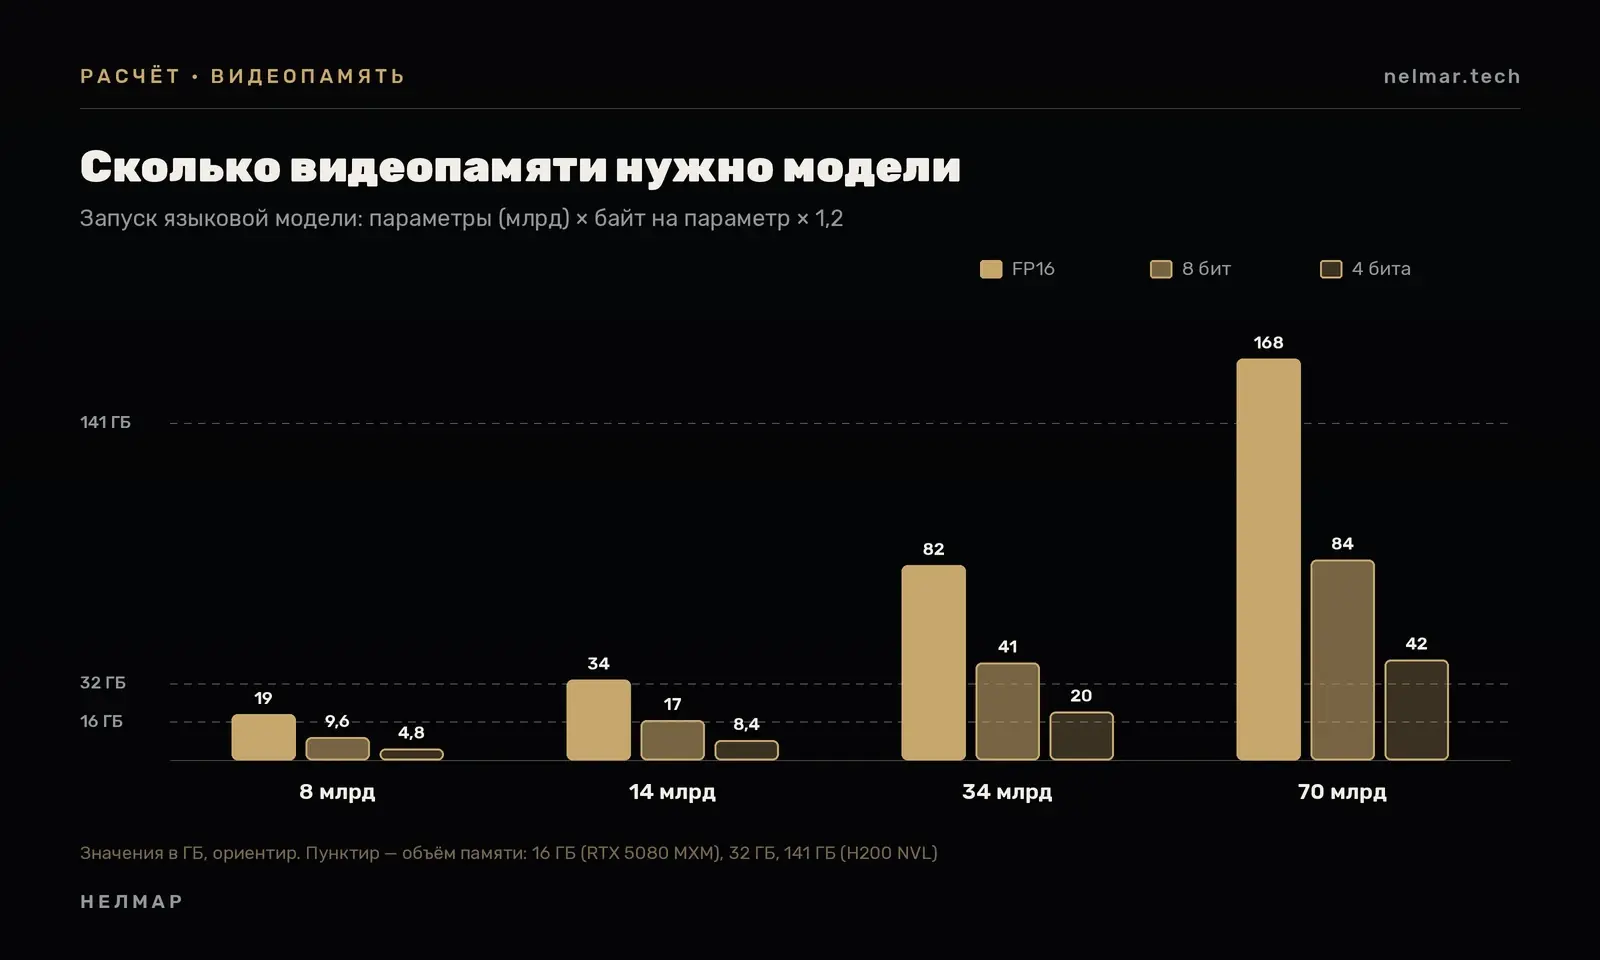
| Размер модели | FP16 / BF16 | 8 бит | 4 бита |
|---|---|---|---|
| 7–8 млрд параметров | ≈ 17–19 ГБ | ≈ 9–10 ГБ | ≈ 4–5 ГБ |
| 13–14 млрд | ≈ 31–34 ГБ | ≈ 16–17 ГБ | ≈ 8–9 ГБ |
| 30–34 млрд | ≈ 72–82 ГБ | ≈ 36–41 ГБ | ≈ 18–21 ГБ |
| 70 млрд | ≈ 168 ГБ | ≈ 84 ГБ | ≈ 42 ГБ |
Расчёт приблизительный: реальный расход зависит от архитектуры модели, длины контекста и программы, которой её запускают. Квантизация экономит память, но может немного снижать качество ответов — проверяйте на своих задачах.
Запуск или обучение: разница в памяти
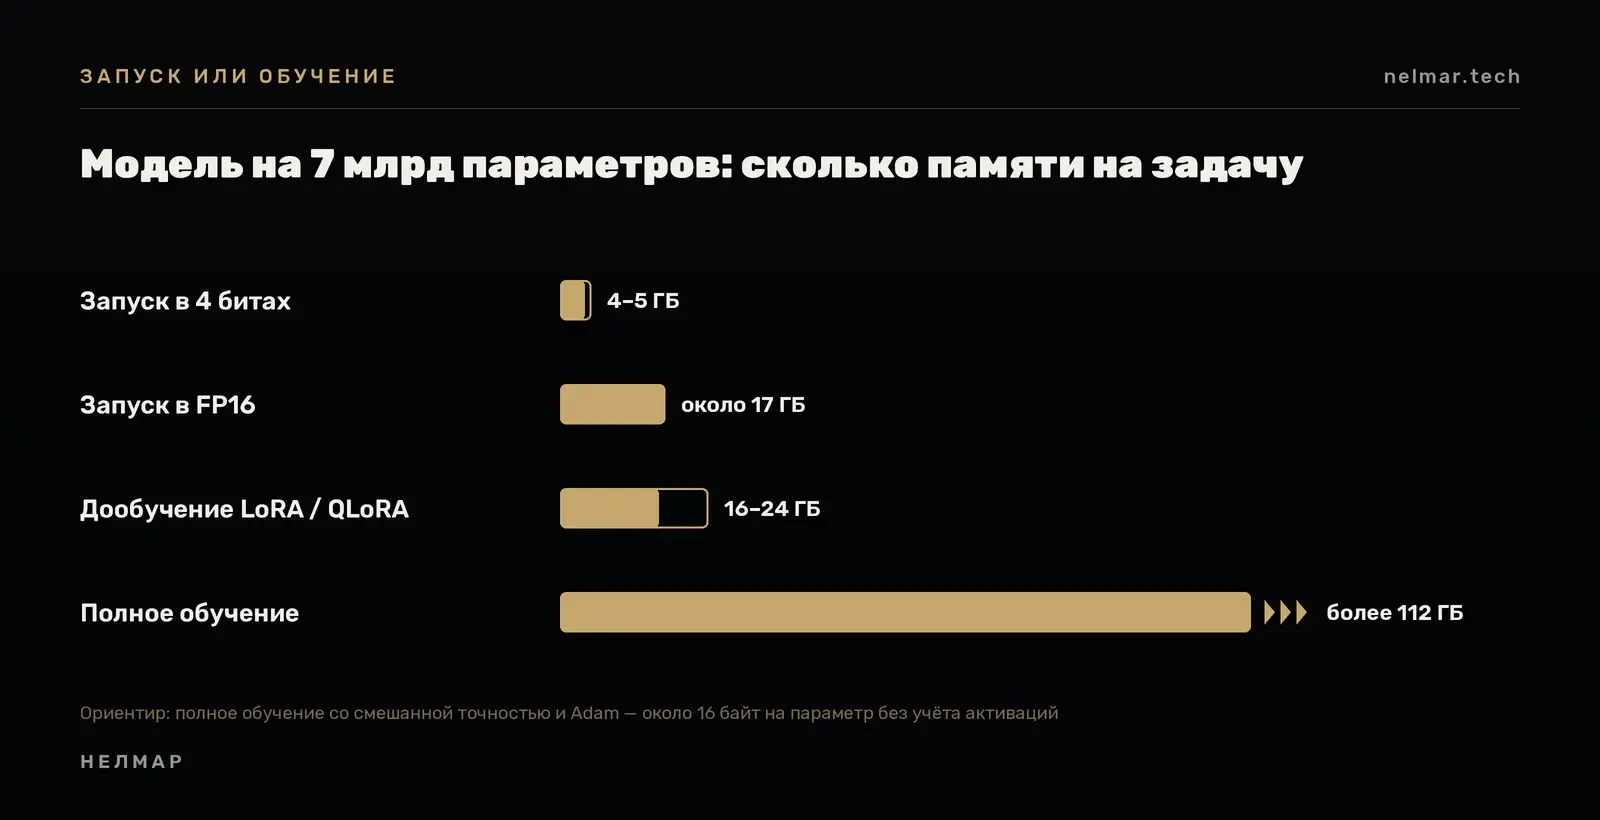
Запуск готовой модели требует памяти по таблице выше.
Полное обучение требует в разы больше. Кроме весов, в памяти хранятся градиенты и состояния оптимизатора. При обучении со смешанной точностью и оптимизатором Adam ориентир — около 16 байт на параметр, без учёта промежуточных данных. Для модели на 7 млрд параметров это уже больше 100 ГБ — задача для нескольких серверных GPU.
Дообучение адаптерами (LoRA, QLoRA) — компромисс. Основные веса заморожены, обучаются небольшие дополнительные слои. Так модели на 7–13 млрд параметров можно дообучать на одной карте с 16–24 ГБ памяти.
Компьютерное зрение — распознавание объектов, контроль качества, видеоаналитика — обычно работает с моделями в десятки и сотни раз меньше языковых. Для них важнее вычислительная мощность и число видеопотоков, чем гигабайты памяти.
Две видеокарты и больше: когда это работает
Если модель не помещается в одну карту, её можно разделить между несколькими GPU. Современные программы для запуска и обучения нейросетей умеют распределять слои модели по картам, и доступная видеопамять примерно складывается.
- Связь между картами. При делении модели GPU постоянно обмениваются данными. Серверные ускорители соединяются быстрыми каналами, а игровые карты последних поколений обмениваются данными только через шину PCIe, и это ограничивает масштабирование.
- Питание и охлаждение. Четыре мощные карты потребляют киловатты и требуют серверного корпуса, продуманного воздушного потока и выделенной линии питания.
- Параллельные задачи. Иногда выгоднее не делить одну модель, а запустить на каждой карте свою задачу: обучение на одной, тестирование на другой, сервис для сотрудников на третьей.
Игровая или серверная видеокарта для нейросетей
| Критерий | Игровая / рабочая карта | Серверный ускоритель |
|---|---|---|
| Видеопамять | 12–32 ГБ | 80–141 ГБ и больше |
| Охлаждение | Активное, вентиляторы | Пассивное, нужен серверный поток воздуха |
| Работа 24/7 под нагрузкой | Возможна, но не основной сценарий | Основной сценарий |
| Объединение карт | Через PCIe | Быстрые межкарточные каналы, конфигурации на 4–8 GPU |
| Для чего | Локальный запуск моделей до 30 млрд параметров, дообучение адаптерами, разработка | Большие языковые модели, обучение, сервисы на много пользователей |
Видеокарты и ИИ-станции от НЕЛМАР
RTX 5080 MXM
Формат MXM Type-B для встраиваемых и промышленных ПК: машинное зрение, видеоаналитика, модели до 7–13 млрд параметров с квантизацией.
ПодробнееВычислительная станция A100W
4 GPU (по каталогу «5090»), 2 × SSD 3,84 ТБ. Обучение и дообучение моделей, компьютерное зрение, ИИ-сервисы внутри компании.
ПодробнееNVIDIA H200 NVL
Большие языковые модели: модель на 70 млрд параметров в 8-битном формате помещается в одну карту.
ПодробнееСервер Inspur NF5280M6
Серверная платформа для графических ускорителей: ИИ, аналитика и корпоративные системы на одной машине.
ПодробнееЕсли модель уже обучена и её нужно запускать на объекте — рядом с камерами или оборудованием, — посмотрите промышленный компьютер для ИИ A100TH. Как выбрать задачу до покупки сервера, читайте в статье «Сервер для нейросетей: как внедрить ИИ и не переплатить».
Подберём GPU и сервер под вашу модель и задачу
Подобрать GPUЧастые вопросы
Какая видеокарта нужна для нейросетей?
С видеопамятью, в которую помещается ваша модель с запасом 20%. Для моделей на 7–8 млрд параметров хватит 16 ГБ, для 30 млрд — 24–48 ГБ, для 70 млрд — от 48 ГБ или несколько GPU.
Сколько видеопамяти нужно для локальной нейросети?
По формуле: число параметров в миллиардах × байт на параметр × 1,2. Модель на 8 млрд параметров в 4-битном формате займёт около 5 ГБ, в FP16 — около 19 ГБ.
Какая видеокарта нужна для обучения нейросетей?
Для полного обучения больших моделей — серверные ускорители с большой памятью и несколько GPU. Для дообучения адаптерами LoRA и QLoRA моделей на 7–13 млрд параметров достаточно одной карты на 16–24 ГБ.
Можно ли использовать две видеокарты для нейросети?
Да. Модель делят между картами, и видеопамять примерно складывается. Но скорость обмена между игровыми картами ограничена шиной PCIe, поэтому для больших моделей лучше серверные GPU.
Что важнее для нейросетей: видеопамять или мощность GPU?
Сначала видеопамять: если модель не помещается, мощность не поможет. Затем пропускная способность памяти — она определяет скорость ответа. Вычислительная мощность важнее всего при обучении.
Игровая или серверная видеокарта для нейросетей?
Игровая подходит для разработки и локального запуска моделей до 30 млрд параметров. Серверная — для больших моделей, обучения и сервисов на много пользователей с работой 24/7.